上一篇把驱动、固件、CANN 打完,npu-smi 能看到 8 张 Ascend950DT,单机跑推理已经没问题了。但一放到 K8s 里就露馅:kubectl describe node 里压根没有 huawei.com/npu 这个资源,Pod 里也看不到 /dev/davinci*。
这篇记录的是从「单机能用」到「集群能调度」的完整过程:所有节点先装 Ascend Docker Runtime,再打节点标签、导镜像,最后用 Helm 把 MindCluster 拉起来,用一个申请 1 张 NPU 的 Pod 验证整条链路。命令和版本都来自实际部署记录,照着核对就行。
一、先厘清顺序
1.1 组件各管各的
MindCluster 不是一坨软件,是一组组件,各自的位置和职责得先分清楚:
| 组件 | 职责 | 落在哪 |
|---|---|---|
| Ascend Docker Runtime | 按传入的 NPU 编号,自动把设备文件和驱动文件挂进容器 | 所有节点,宿主机进程,不是 Pod |
| Ascend Device Plugin | 向 K8s 上报 NPU 数量、编号、健康状态;配合 Runtime 完成芯片挂载 | 计算节点 |
| NodeD | 节点异常检测,把 CPU、内存、硬盘的健康状态上报给 ClusterD | 计算节点 |
| ClusterD | 汇总集群的昇腾任务与资源信息,提供查询接口;判断任务是否需要训练/推理的高阶恢复,并协调恢复过程 | 管理节点 |
| NPU Exporter | 暴露利用率、温度、电压、内存等指标,支持自定义插件补充指标 | 计算节点 |
| Volcano(vc-scheduler / vc-controller-manager) | 感知可用芯片,结合网络与资源碎片选择最优调度;任务运行中芯片故障时重新选卡恢复 | 管理节点 |
| Ascend Operator | 昇腾相关 CRD 的编排与生命周期管理 | 管理节点 |
一句话概括:Runtime 管挂载,Device Plugin 管上报,NodeD 管健康,ClusterD 管决策,Exporter 管监控,Volcano 管调度,Operator 管编排。
1.2 为什么 Runtime 必须单独先装
Helm 只能管 K8s 里的资源,管不到宿主机。而 Ascend Docker Runtime 恰好是宿主机上的二进制,它改的是 containerd 的运行时配置——这部分必须手工装,且必须在 Helm 之前。
装它的意义在于:容器创建时不用写一长串 --device 和目录挂载,只要声明 NPU 编号,Runtime 自动把该挂的都挂进去。而且这份挂载清单会随芯片迭代变化,交给 Runtime 跟着版本走,比自己维护靠谱得多。
用到容器化支持、整卡调度、静态 / 动态 vNPU 调度、断点续训、弹性训练、芯片故障恢复或重调度的,都绕不开它。
所以完整顺序是:驱动 / 固件 → CANN → Ascend Docker Runtime → Helm 装 MindCluster。少任何一层,后面 Device Plugin 起来了也报不出资源。
二、安装 ADR
所有节点都要装,不只是计算节点。管理节点要是也带卡、也要跑任务(本文的 mgmt015 就是既管理又计算),一样得装。
本文是 K8s 集成 Containerd(RKE2) 的场景。Docker 直连、原生 containerd 等其他场景,按上面官方文档对号入座,别照抄这一段。
2.1 先给 containerd 加一个运行时
RKE2 的 containerd 主配置是自动生成的,直接改 config.toml,重启一次就被覆盖回去。正确做法是用它支持的 drop-in 目录 config-v3.toml.d:
mkdir -p /data/rancher/rke2/agent/etc/containerd/config-v3.toml.d

cat > /data/rancher/rke2/agent/etc/containerd/config-v3.toml.d/99-ascend.toml <<'EOF'
[plugins.'io.containerd.cri.v1.runtime'.containerd]
  default_runtime_name = "ascend"

[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.ascend]
  runtime_type = "io.containerd.runc.v2"
  [plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.ascend.options]
    BinaryName = "/usr/local/Ascend/Ascend-Docker-Runtime/ascend-docker-runtime"
    SystemdCgroup = true
EOF

cat /data/rancher/rke2/agent/etc/containerd/config-v3.toml.d/99-ascend.toml
几个点值得说清楚:
default_runtime_name = "ascend"把默认运行时切过去,所有 Pod 都走它。不设默认,就得在每个 Pod 上显式指定 RuntimeClass,调度链路凭空多一环。runtime_type依然是io.containerd.runc.v2,底层还是 runc,只是把BinaryName换成了 Ascend 的包装程序:它先按需注入设备挂载,再交给 runc 起容器。BinaryName必须和后面的--install-path对得上:/usr/local/Ascend+Ascend-Docker-Runtime/ascend-docker-runtime。SystemdCgroup = true要和 kubelet 的 cgroup driver 保持一致,RKE2 默认就是 systemd。- 文件名前缀
99-决定加载顺序,保证这份配置最后生效。 - 最后那行
cat不是凑数,改完立刻核对一遍,比重启完再排查省事得多。
2.2 校验安装包
chmod +x Ascend-docker-runtime_26.1.1_linux-aarch64.run
./Ascend-docker-runtime_26.1.1_linux-aarch64.run --check
--check 先查包完整性和环境依赖。别省,装到一半报缺依赖再回滚更麻烦。
2.3 安装
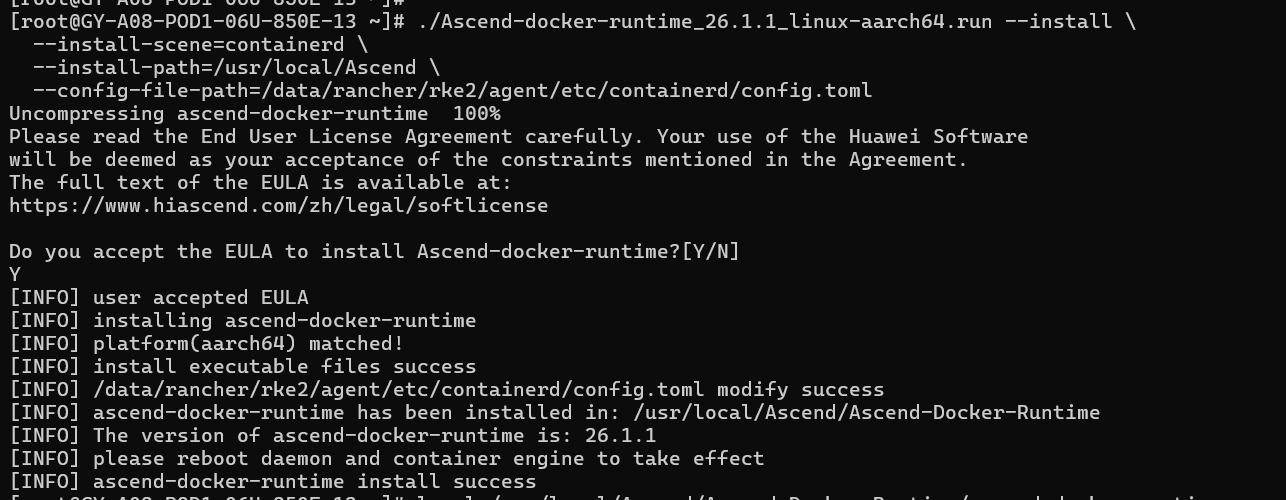
./Ascend-docker-runtime_26.1.1_linux-aarch64.run --install \
  --install-scene=containerd \
  --install-path=/usr/local/Ascend \
  --config-file-path=/tmp/adr-containerd-conf/config.toml
--install-scene=containerd:明确告诉安装脚本改的是 containerd 场景,别跑去动 docker 的daemon.json。--install-path=/usr/local/Ascend:装到 CANN 同一棵目录树下,和前面 drop-in 里的BinaryName对应。--config-file-path这一行是整段里最需要留意的:路径刻意指向一个临时文件。RKE2 下这个参数没有实际作用,真实配置已经通过config-v3.toml.d的 drop-in 生效了;给个临时路径,就是为了不让安装脚本去改 RKE2 自动生成的主配置。要是这里老老实实填了真实config.toml,脚本会往里写一段它自己的配置,RKE2 重启时又覆盖回去,两边打架,排查起来很难受。
输入 Y 确认安装,看到安装成功的回显,这一步就算过了。
2.4 重启并确认节点
systemctl restart rke2-server && sleep 20
sleep 20 是等 containerd、kubelet 重新拉起,节点回到 Ready,别急着敲下一条。
注意管理节点和计算节点的服务名不一样:管理节点重启 rke2-server,纯计算节点(agent)对应的是 rke2-agent,别整集群敲同一条命令。
ls -l /usr/local/Ascend/Ascend-Docker-Runtime/ascend-docker-runtime
kubectl get nodes
npu-smi info
三条分别确认二进制在位、节点都 Ready、宿主机 NPU 没被这一通操作影响。都正常再往下走。
三、打节点标签
MindCluster 的组件靠 nodeSelector 找节点,标签的键和值都是写死的,不能自己发挥:
| 标签 | 作用 | 使用的组件 |
|---|---|---|
masterselector=dls-master-node | 标识 MindCluster 的管理节点 | Volcano、Ascend Operator、ClusterD |
workerselector=dls-worker-node | 标识 MindCluster 的计算节点 | Ascend Device Plugin、NodeD、NPU Exporter |
组件里的选择条件是长这样的:
nodeSelector:
  masterselector: dls-master-node
---
nodeSelector:
  workerselector: dls-worker-node
K8s 调度器按这些标签把组件调度到对应节点,组件到位之后才开始读驱动、上报资源、采集指标。
3.1 管理节点(同时也是计算节点)
如果把带昇腾 AI 处理器的节点作为 K8s 管理节点,那它既是管理节点又是计算节点,两组标签都得打:
# 管理节点(950DT,既管理又计算)
kubectl label nodes mgmt015 masterselector=dls-master-node
kubectl label nodes mgmt015 workerselector=dls-worker-node
少打一个,就有一半组件一直 Pending。
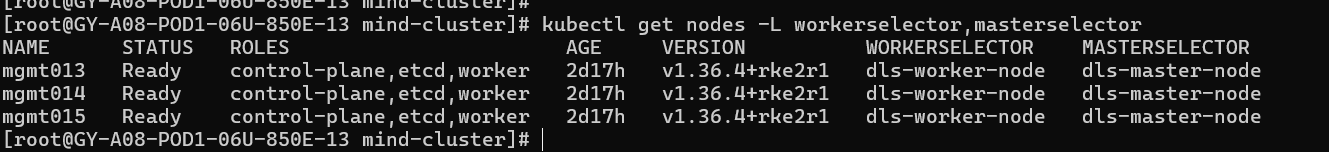
验证:
kubectl get nodes -L workerselector,masterselector
3.2 计算节点
kubectl label nodes worker01 workerselector=dls-worker-node
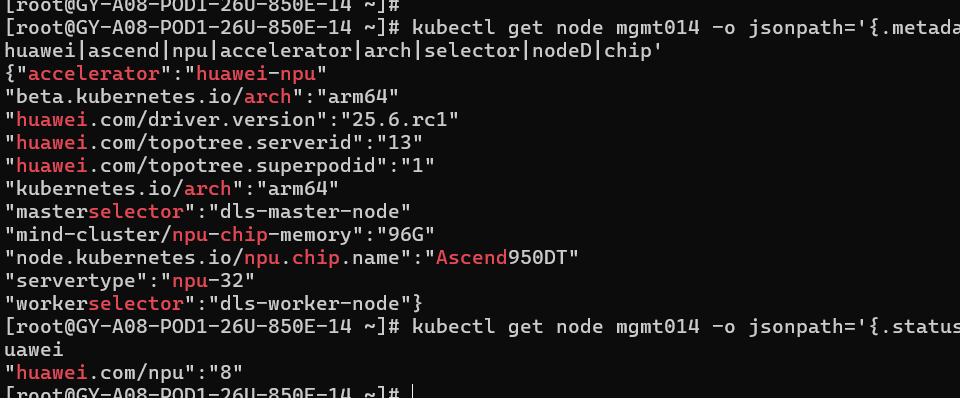
这里有个反直觉的地方:不需要给显存、芯片型号这些打标签。后续 Device Plugin 会读驱动自动上报,手打反而容易和实际上报值对不上。
四、导入镜像
离线环境,得先把镜像灌进 containerd,或者统一推到内网 Harbor 再让各节点拉。。
4.1 配 containerd 环境变量
export CONTAINERD_ADDRESS=/run/k3s/containerd/containerd.sock
export CONTAINERD_NAMESPACE=k8s.io
第一行容易让人愣一下:明明装的是 RKE2,socket 却是 k3s 路径。RKE2 本身就是基于 k3s 的发行版,containerd 的 socket 沿用了 /run/k3s/containerd/containerd.sock,没写错。
第二个变量更关键:ctr 默认操作 default 命名空间,而 K8s 用的镜像全在 k8s.io。不导进去,kubectl 起 Pod 时还是找不到镜像,转头去公网拉,直接 ImagePullBackOff。
4.2 镜像清单
swr.cn-south-1.myhuaweicloud.com/ascendhub/ascend-operator:v26.1.1-openeuler24.03
swr.cn-south-1.myhuaweicloud.com/ascendhub/ascend-k8sdeviceplugin:v26.1.1-openeuler24.03
swr.cn-south-1.myhuaweicloud.com/ascendhub/clusterd:v26.1.1-openeuler24.03
swr.cn-south-1.myhuaweicloud.com/ascendhub/infer-operator:v26.1.1-openeuler24.03
swr.cn-south-1.myhuaweicloud.com/ascendhub/noded:v26.1.1-openeuler24.03
swr.cn-south-1.myhuaweicloud.com/ascendhub/npu-exporter:v26.1.1-openeuler24.03
swr.cn-south-1.myhuaweicloud.com/ascendhub/vc-controller-manager:v1.9.0-v26.1.1-openeuler24.03
swr.cn-south-1.myhuaweicloud.com/ascendhub/vc-scheduler:v1.9.0-v26.1.1-openeuler24.03
前 6 个是 MindCluster 组件,后两个 vc-* 是 Volcano。26.1.1 的部署包会把 Volcano 一并拉起,所以后面验证 Pod 才能写 schedulerName: volcano。
版本后缀 -openeuler24.03 要和系统对上,别混用别的发行版镜像。
4.3 导入、改 tag、推送
以 ascend-operator 一个镜像为例,单镜像走一遍是这样(这一步是测试用的,实际部署请按这个套路写脚本批量循环,8 个一个都不能漏):
rke2-ctr images import operator.tar
rke2-ctr images tag swr.cn-south-1.myhuaweicloud.com/ascendhub/ascend-operator:v26.1.1-openeuler24.03 172.16.0.204:32500/ascendhub/ascend-operator:v26.1.1-openeuler24.03
rke2-ctr images push --plain-http 172.16.0.204:32500/ascendhub/ascend-operator:v26.1.1-openeuler24.03
# 查看结果
rke2-ctr images ls -q | grep -v '^sha256'
import把 tar 包导进 containerd,落在前面设的k8s.io命名空间。tag把公网 SWR 域名换成内网 Harbor 地址。chart 里的 image 字段填的是内网地址,名字对不上就是 ImagePullBackOff。--plain-http是因为内网 Harbor 走 HTTP,不加会默认尝试 HTTPS,报 TLS 错误。- 最后一行用
grep -v '^sha256'滤掉 digest 行,只留可读的镜像名。
五、Helm 安装 MindCluster
版本:26.1.1。
5.1 解压部署包
unzip Ascend-helm-deploy-tool_26.1.1_linux.zip
图 4 | 解压后的部署包目录
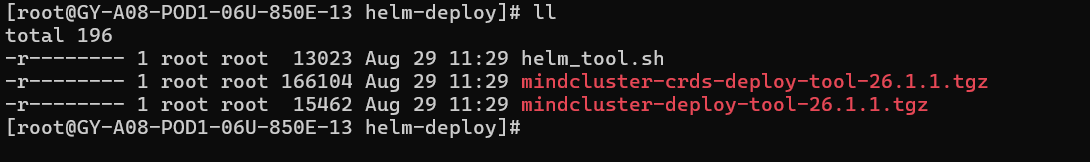
解压出来最关键的是两个 .tgz:mindcluster-crds-deploy-tool-26.1.1.tgz 和 mindcluster-deploy-tool-26.1.1.tgz。顺序不能反——先把 CRD 装好,应用组件里的自定义资源才有类型可用。
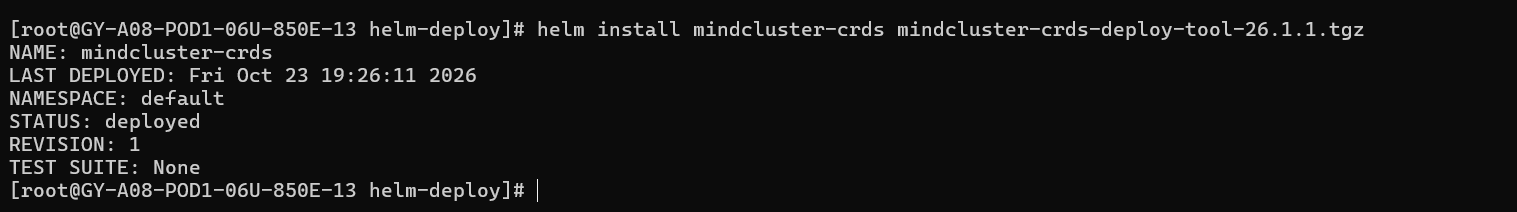
5.2 安装 CRDs
#(可选)--dry-run 不实际创建任何资源,用来验证模板语法、检查生成的配置是否符合预期
helm install mindcluster-crds mindcluster-crds-deploy-tool-26.1.1.tgz --dry-run
# 正式执行安装
helm install mindcluster-crds mindcluster-crds-deploy-tool-26.1.1.tgz
5.3 安装应用组件
#(可选)--dry-run 同上
helm install mindcluster mindcluster-deploy-tool-{chart_version}.tgz --dry-run
# 正式执行安装
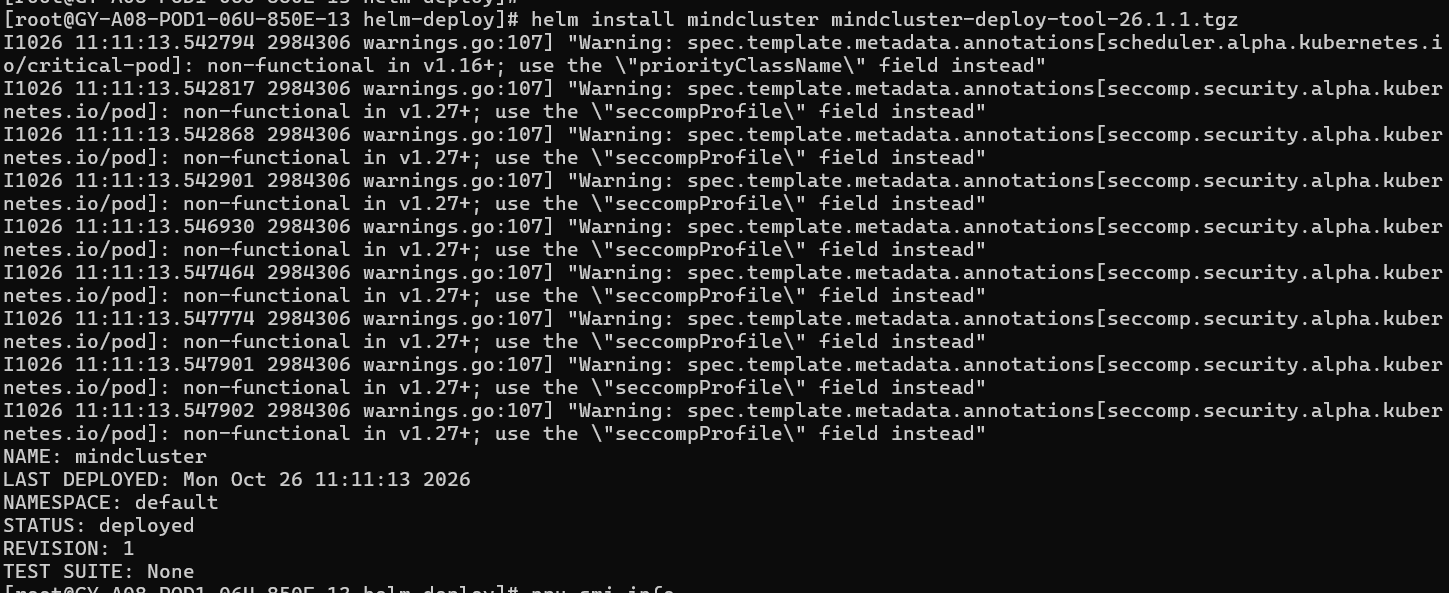
helm install mindcluster mindcluster-deploy-tool-26.1.1.tgz
{chart_version} 换成实际版本号,本篇就是 26.1.1。两个 Release 名字(mindcluster-crds / mindcluster)保持一致,helm list 里好认。
5.4 查看安装结果
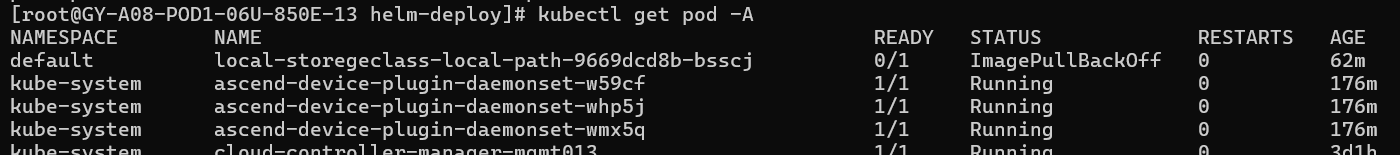
helm list
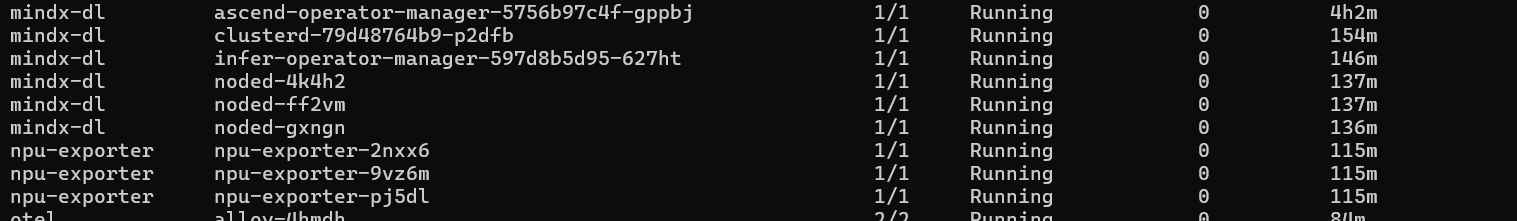
kubectl get pods -A | grep -Ei 'ascend|clusterd|noded|npu-exporter|volcano'
判断标准:管理节点上应该有 ClusterD、Ascend Operator、Volcano 的 scheduler 和 controller-manager;计算节点上应该有 Device Plugin、NodeD、NPU Exporter。哪个没起来,先回第三节检查节点标签打对没有——绝大多数 Pending 都出在那儿。
六、验证
前面全是铺垫,这一步才是验收。
cat <<'EOF' | kubectl apply -f -
apiVersion: v1
kind: Pod
metadata:
  name: npu-check2
  annotations:
    huawei.com/schedule_policy: chip2-node16
spec:
  schedulerName: volcano
  restartPolicy: Never
  containers:
    - name: c
      image: 172.16.0.204:32500/ascendhub/ascend-operator:v26.1.1-openeuler24.03
      command: ["/bin/sleep", "3600"]
      resources:
        limits:
          huawei.com/npu: "1"
EOF

sleep 25
kubectl get pod npu-check2 -o wide
kubectl describe pod npu-check2 | sed -n '/Events/,$p'
resources.limits.huawei.com/npu: "1"是向 K8s 申请 1 张卡,这个资源名由 Device Plugin 上报。能调度成功,就说明「驱动 → Runtime → Device Plugin → 调度器」整条链路通了。schedulerName: volcano走 Volcano 调度,对应的就是镜像清单里那两个vc-*组件。huawei.com/schedule_policy: chip2-node16是调度策略注解,按集群实际策略填。restartPolicy: Never加sleep 3600是为了让 Pod 停在那儿,方便进去查设备挂载。sleep 25等镜像拉取和容器启动。Pod 一创建就describe,那时还在 Pending,很容易误判成调度失败。
Pod 起来之后,进容器确认设备节点挂进来了:
kubectl exec -it npu-check2 -- ls /dev/davinci*
镜像里如果带了 npu-smi,也可以直接 kubectl exec -it npu-check2 -- npu-smi info,输出应当和宿主机对得上。
再看节点侧的资源账:
kubectl describe node mgmt015 | grep 'huawei.com/npu'
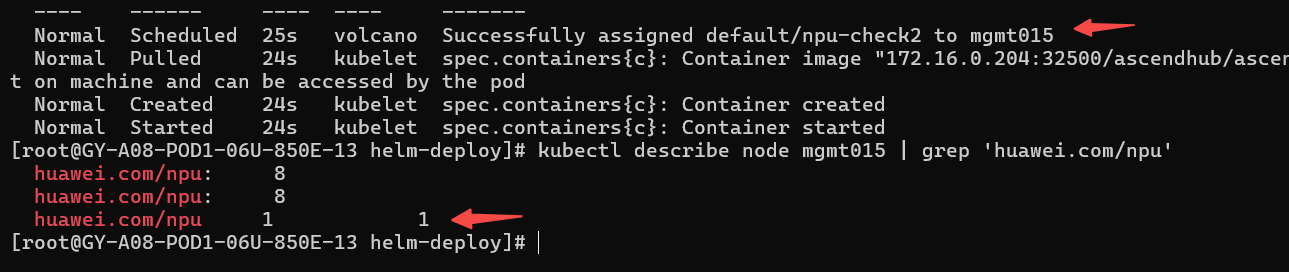
Capacity 和 Allocatable 里出现卡数、并且已经分配走 1 张,这就是「集群认得 NPU」最直接的证据。
七、几个容易忽略的点
把这次流程里最容易出问题的地方单独拎出来:
| 位置 | 容易踩的地方 | 后果 |
|---|---|---|
| Runtime 配置 | 直接改 RKE2 自动生成的 config.toml | 重启被覆盖,配置丢失 |
| Runtime 安装 | --config-file-path 填了真实主配置 | 脚本写入的内容和 RKE2 生成逻辑冲突 |
| Runtime 安装 | 只在计算节点装 | 管理节点也带卡时,那边起的容器挂不到设备 |
| 重启服务 | 全集群统一敲 rke2-server | agent 节点上服务名不对,节点起不来 |
| 节点标签 | 值自己改了 / 既管又算只打一个 | 组件一直 Pending,资源不上报 |
| 节点标签 | 手打显存、芯片型号 | 与 Device Plugin 实际上报值不一致 |
| 镜像导入 | 没设 CONTAINERD_NAMESPACE=k8s.io | 镜像进了 default,Pod 仍去公网拉 |
| 镜像导入 | 没把 tag 改成内网 Harbor 地址 | chart 里的 image 名对不上 |
| 镜像推送 | 少了 --plain-http | 内网 HTTP Harbor 报 TLS 错误 |
| Helm 顺序 | 先装应用 chart 再装 CRDs | 自定义资源无类型,组件起不来 |
| 验证 | Pod 一创建就 describe | 还在 Pending,误判成调度失败 |
这几条都不是疑难杂症,但每一条都能让流程卡半天,而且报错信息通常不会直接指向真实原因。
八、最后
到这一步,kubectl describe node 里能看到 huawei.com/npu,Pod 里能看到 /dev/davinci*,整条链路就算通了:驱动让系统认得卡,CANN 让单机能算,Ascend Docker Runtime 让容器拿得到卡,Device Plugin 让 K8s 会分配卡,Volcano 决定分哪张卡。
上篇说「先把地基打完」,这篇就是把地基上面的调度层补齐。再往后是往里跑真实任务——断点续训、故障重调度这些高阶能力,都是在这个底座上叠。
还有一件事这篇没做:Helm 装完,NPU Exporter 其实已经在每个计算节点上跑着了,利用率、温度、电压、内存这些指标就在 8082 端口上,只是还没人去抓。集群一旦上量,「卡在不在跑、跑得满不满、有没有过热」总不能靠 ssh 上去敲 npu-smi。把指标接进 Prometheus、做成 Grafana 面板,单独放下一篇写。
最后照例提醒:本文走的是 RKE2 + containerd 这一条路径。换成原生 containerd、Docker 或者别的 K8s 发行版,Runtime 那段配置的落点全都不一样,别照抄,按官方文档的场景对号入座。
评论区