超节点这东西,物理上是上百上千台服务器堆在一起,凭什么敢说它“像一台机器”?算力堆上去不难,难的是让这几千几万张卡互相说话的时候,不觉得自己隔着一堵墙。
昇腾这套体系里,这个问题的答案叫灵衢(UnifiedBus,UB)。
我们这边有一批 Atlas 850E,最近简单测试了一下灵衢。测完先给结论:
灵衢不是一条更快的网,而是一根被拉长到机柜外面的内存总线。
1. 先记住三个词
灵衢这个词,“衢”是四通八达的大路。华为起名字挺实在,它干的就是修路——修一条让所有计算单元都以为自己还在同一个主板上的路。
它不算新东西。2019 年就开始研究了,灵衢 1.0 先在 Atlas 900(384 卡)上跑通商用。2025 年 9 月的全联接大会上,华为把灵衢 2.0 的三份规范公开了:《基础规范》《固件规范》《使能操作系统参考设计》,外加一份超节点参考架构白皮书。到 2026 年 9 月,基础规范更新到 2.1,加了 224/256 Gbit/s 的链路速率和可靠重路由。
规范里给超节点定了六个特征:总线级互联、协议归一、平等协同、全量池化、大规模组网、高可用。词挺多,其实前两个是根,后面四个都是它俩长出来的。
至于超节点为什么难——不难在算力,难在通信的“说法”不对。这一点下一节展开。
2. 它不是网,是总线
很多人第一次听灵衢,第一反应是问带宽:多少 TB/s?跟 InfiniBand 比谁快?
这个问法方向就偏了。
先说寄快递和伸手拿
走以太网(包括 RoCE)传一份 KV Cache,链路是这样的:应用组包 → 本机网卡 DMA → 交换机 → 对端网卡 → 对端内存 → 再搬进显存。数据至少落两次地,中间还夹着协议栈、软中断、队列管理。
灵衢换了一套说法:A 机的 NPU 直接 Load/Store B 机的内存。不打成网络包,不经网卡转发,数据一次都不落地。
打个比方。以太网是寄快递——装箱、填单、交件、签收、拆箱,每一步都得走。灵衢是伸手拿——你直接把胳膊伸到隔壁桌的抽屉里,把东西拿出来。
带宽可以堆,但“伸手”和“寄快递”之间差的那几个来回,堆不出来。
这也是为什么现在做推理的 KV Cache 池化、PD 分离,底层都盯着这类内存语义的互联。跨机取一次 KV Cache,如果还要走一遍网络协议栈,省下来的算力又被通信吃回去了。
六层,只记两个入口
灵衢的协议栈有六层:物理层、数据链路层、网络层、传输层、事务层、功能层。名字看着唬人,其实和别的网络协议差不多,一层管一件事。
真正需要记住的是最上面那层给了你两个入口:
**一个是 UB Memory,同步的。**你拿到的是一个指针,Load/Store 直接打到对端内存去。中间由 UMMU 做地址翻译和权限校验,通过了就放行。写代码的人不用管对面那台机器在哪。
**一个是 URMA,异步的。**把请求塞进队列,交给一个叫 Jetty 的东西(可以理解成“通信码头”)去跑,支持 Write / Read / Send / Atomic,还能走多路径、允许乱序回来。
一个像伸手,一个像派快递员。要低时延用前者,要吞吐和并发用后者。
除了六层,还有两个不在层里但离不开的角色:UMMU 管地址和权限,UBFM 管“谁是谁、路怎么走”。数据面和控制面从一开始就分开了,这个设计挺干净。
三个传输模式
这块值得单独说,因为后面我的命令里会用到。
灵衢的传输层有三档:
- RTP:可靠传输,端到端重传,能撑 4 个 Port
- CTP:轻量传输,不做端到端重传,可靠性交给链路层兜底,能撑 9 个 Port
- UTP:不可靠、无连接,给带内建链这种丢包无所谓的业务
链路层自己已经做了 CRC 和点对点重传,所以 CTP 敢把端到端的重传省掉。省掉的是时延和缓冲。这就是典型的“知道楼下地基够硬,楼上就敢盖薄”。
我测试时加了 --ctp,原因就在这儿。
3. 950DT 的账本
先把参数摆出来,心里有个数。
昇腾 950 是“一芯双构”:同一颗 Die,配 HiBL 1.0 做成 950PR(偏 Prefill 和推荐),配 HiZQ 2.0 做成 950DT(偏 Decode 和训练)。850E 和云上超节点用的都是 950DT。
华为云 AICS 灵衢智算集群当前规格页上,单颗 NPU 是这么写的:FP16 算力 486 TFLOPS,显存带宽 4 TB/s,显存 96 GB,低精度支持 MXFP4 1784 TFLOPS、MXFP8 919 TFLOPS。
这三个数里,我建议你盯 4 TB/s。做推理的都知道,访存带宽往往比算力更早成为瓶颈,算力再高,喂不饱也是白搭。
超节点分 64 卡和 1024 卡两档。1024 卡那个是 128 个节点、24576 核 CPU、768 TB 内存,Scale-up 每颗 NPU 1.68 TB/s、合计 1720 TB/s,Scale-out 每颗 NPU 200 Gb/s。开服区域是华东二、华北三、西南-贵阳一。
超节点层面还有几个数值得记:
- 单柜 64 卡是基本单元,最大 1024 卡,按 64 卡步长往上加
- 跨柜卡间往返时延从 7 μs 降到 3 μs
- 全局统一内存编址,1024 卡规模下 256 TB
- 访存带宽 4 PB/s,互联带宽 16.3 PB/s
这里有个细节我不替谁圆场:**发布会讲 950DT 的 HiZQ 2.0 是 144 GB 显存,但 850E 规格页和 AICS 规格页写的都是 96 GB。**两处官方口径对不上,大概率是封装或 SKU 差异。你真要算显存账,按 96 GB 算更保险。
云上那份产品现在标的是“昇腾950超节点全新发布上线,欢迎申请公测”,卖点四条:1024 卡互联、千卡分钟级创建、故障发现率 >98%、通信时延降低 8 倍。前两条是架构给的,后两条是运维给的。
4. 我的三步实测
说回验证。三台机器都在同一个超节点里,主机名是 GY-A08-POD1-06U-850E-13、-26U-850E-14、-26U-850E-15。注意 06U 和 26U 是不同机柜位——这一组是跨柜的。
我要验的只有一件事:这套 UB 到底通没通,通到哪一层。
先看设备节点
ls /dev/uburma/

出来 10 个,udmac0d1e2 到 udmac0d1e6,再加 udmac1d1e2 到 udmac1d1e6,两组各 5 个。
光看这个路径就有信息了:/dev/uburma。URMA 是灵衢功能层的异步入口,设备节点出现在 /dev 下面,说明它走的是内核驱动 + 用户态直通,不是网卡那一套。
顺便提一句,MOONCAKE_PROTOCOL=ascend 这个环境变量要生效,靠的就是 /dev/ummu、/dev/uburma、urma_admin 这三样。少一个都起不来。
再看 EID
UB 网络里的“IP 地址”叫 EID(Entity ID)。通信的基本单位叫 Entity,每个 Entity 有个全局唯一编号,就是 EID。
/usr/bin/urma_admin show
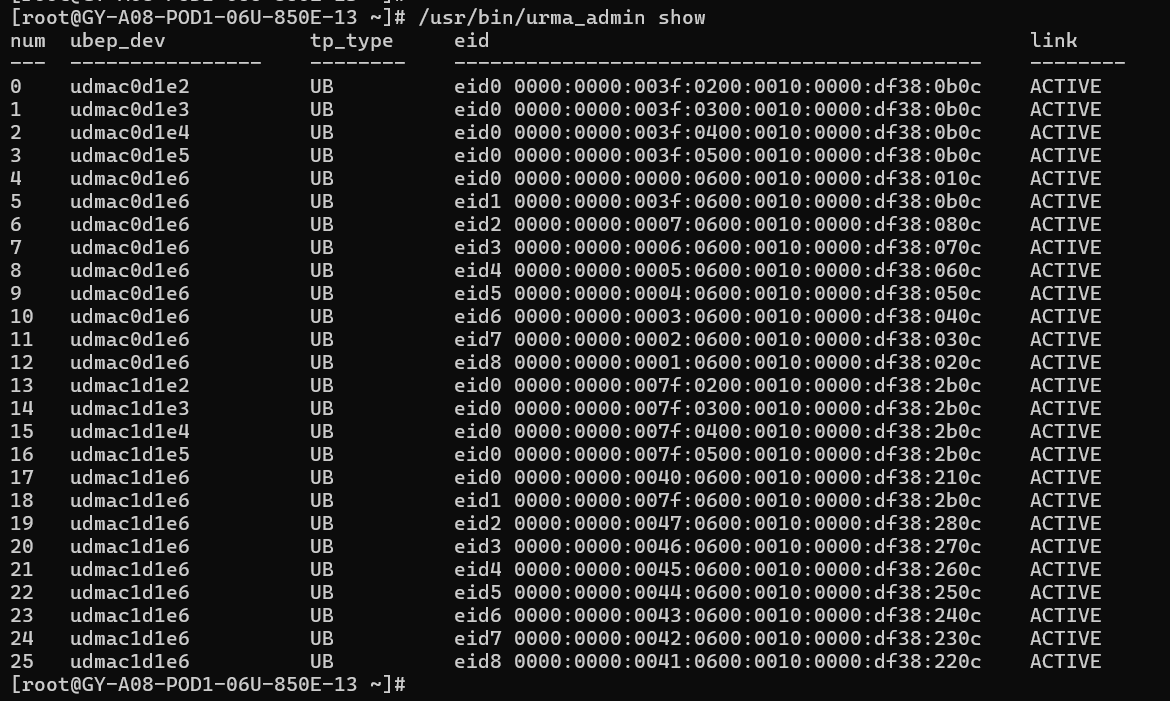
这张图信息量够大,一列一列看:
- num 从 0 到 25,一共 26 个 EID
- ubep_dev 就是前面那 10 个设备
- tp_type 全是 UB,没混进 RoCE
- Link 全是 ACTIVE
- EID 长这样:0000:0000:003f:0200:0010:0000:df38:0b0c
最值得看的是 EID 怎么分的:**udmac0d1e6 和 udmac1d1e6 各自挂了 9 个 EID(eid0 到 eid8),其余 8 个设备各挂 1 个。**两组,每组 4×1+9=13,合计正好 26,和行数对得上。
一个设备挂 9 个 EID 是什么意思?意思是这个物理端点在做多路径聚合——同一条物理链路可以有多条逻辑路径,包可以逐包、逐流地选路。这就是灵衢网络层“多路径负载均衡”在设备视图里的样子。要是这里一个设备只有一个 EID,那多路径就只能在软件层硬凑了。
顺手对一下 850E 的硬件:每颗 NPU 有 15 个 UB 端口,7 个用于框内 8 卡 Full Mesh,8 个(4 个 800G OSFP)直出面板。单颗 NPU 互联带宽 = 15 × 4 × 112 Gbps ≈ 6.72 Tb/s 单向,双向就是 1.68 TB/s。
但别把 /dev/uburma 的设备数(5 个)当成端口数(15 个),这是两套抽象,不是一个东西。
最后跨机跑一发
工具是 urma_perftest,老规矩:服务端等,客户端连。
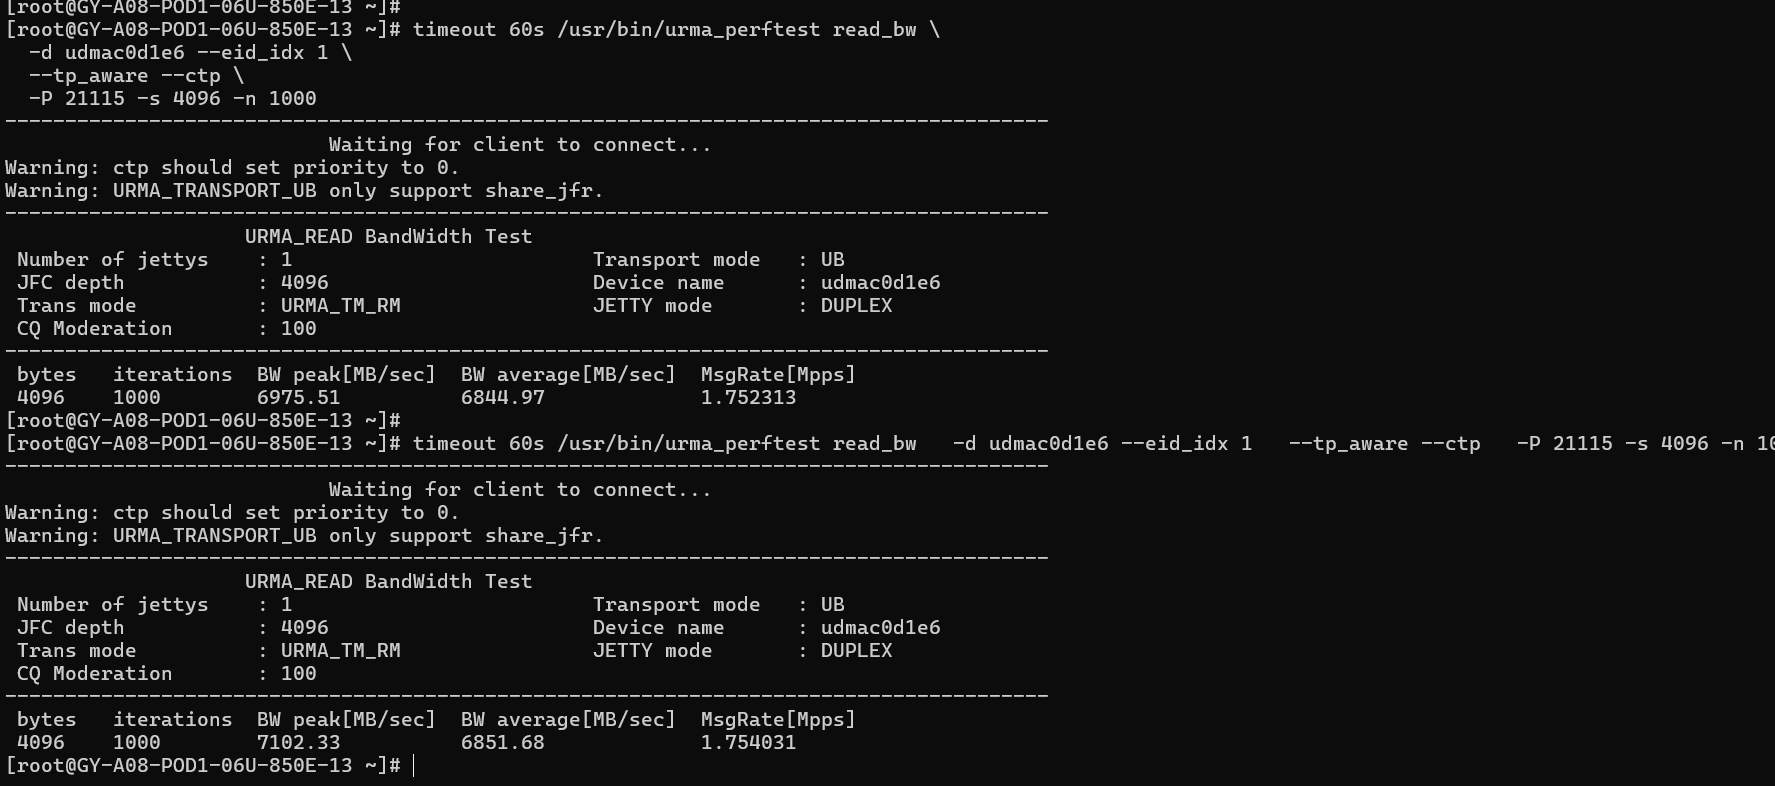
13 号机做服务端:
timeout 60s /usr/bin/urma_perftest read_bw \
  -d udmac0d1e6 --eid_idx 1 \
  --tp_aware --ctp \
  -P 21115 -s 4096 -n 1000
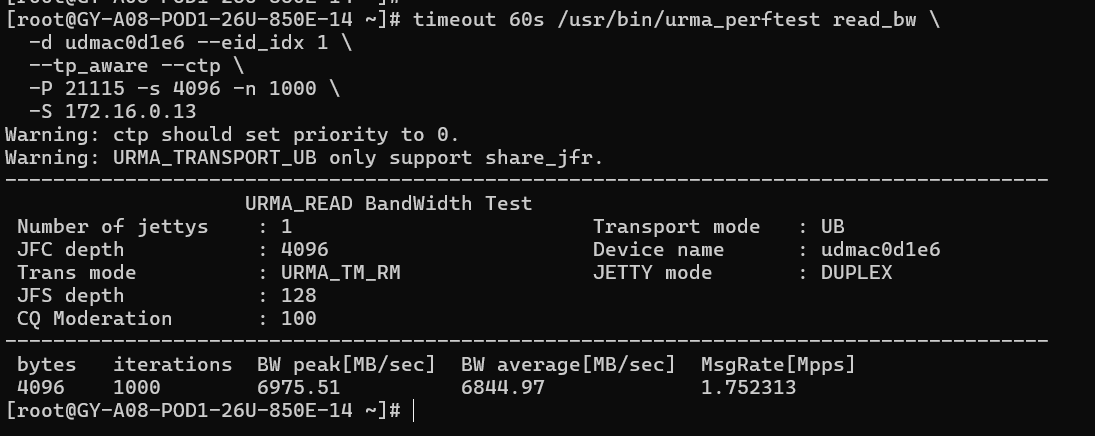
14、15 号机做客户端,命令一样,只多一个 -S 指向服务端:
timeout 60s /usr/bin/urma_perftest read_bw \
  -d udmac0d1e6 --eid_idx 1 \
  --tp_aware --ctp \
  -P 21115 -s 4096 -n 1000 \
  -S 172.16.0.13
输出里最该盯的一行,不是带宽,是这句:
Transport mode : UB
两端都明确写着 UB,没有退回 RoCE。这一行出现,才说明 EID 分配、UMMU 映射、URMA 建链这一整条链路真的通了。
**验 UB 最容易翻车的地方就在这儿:命令能跑、数字也出得来,但 Transport mode 悄悄退化成 RoCE 了。**所以第一优先级是看它有没有偷偷降级,第二才是看数字好不好看。
1000 次读全部完成,没有失败重试。
5. 这个速度怎么看
数字先摆齐:
| 位置 | BW peak | BW average | MsgRate |
|---|---|---|---|
| 服务端 第 1 轮 | 6975.51 MB/s | 6844.97 MB/s | 1.752313 Mpps |
| 服务端 第 2 轮 | 7102.33 MB/s | 6851.68 MB/s | 1.754031 Mpps |
| 客户端(-S 13) | 6975.51 MB/s | 6844.97 MB/s | 1.752313 Mpps |
峰值约 7.1 GB/s,均值 6.85 GB/s,消息速率 1.75 Mpps。
看到这个数,估计有人要笑:1.68 TB/s 的东西,你测出 6.8?
别急着笑,这次测试的条件注定了只能测出这个数:
- **只有一条车道。**输出里 Number of jettys : 1,单条通信通道打满。开 8 条、16 条,是另一个数量级
- **包太小。**4096 字节是测延迟用的包长,不是测带宽的
- **一个人搬。**URMA_TM_RM 远端内存读,单线程顺序等返回,流水线根本没压满
- **排队窗口太浅。**JFS depth 只有 128,在途请求数上不去。带宽 ≈ 在途字节 / 往返时延,窗口浅,带宽就上不去
所以 6.8 GB/s 是“单车道、小包、一个人搬”的成绩,不是灵衢的天花板。1.68 TB/s 是 15 个端口聚合的双向理论值,两者中间隔着端口数、队列深度、包长三堵墙。
但这个测试里有个数字比带宽值钱:1.75 Mpps。
为什么?因为集合通信的真实流量里,小包占大头——AllReduce 的同步消息、MoE 的 token 分发、PP 的激活传递,包都不大。小包场景拼的不是每秒多少 GB,是每秒能甩出多少个消息。1.75 Mpps 是单 jetty、单流下的消息率,想再往上,得靠多 jetty 并行和 CTP 多端口。
顺便把输出里那两行 warning 解释一下,省得你踩:
- Warning: ctp should set priority to 0:用 CTP 时优先级必须归零。CTP 不做端到端重传,优先级队列会打乱链路层兜底的顺序假设
- Warning: URMA_TRANSPORT_UB only support share_jfr:UB 传输模式只支持共享 JFR,独立的接收队列在这条路上不成立
这俩不是报错,是使用约束。CTP 换来的是低时延,代价是重传责任下沉到链路层,所以上层不能乱改语义。
6. 它解决了什么
回到开头那句话:它不是更快的网,是拉长的内存总线。这句话往下拆,有四层意思。
**第一层,写代码的方式变了。**跨机取数据从“发请求、等响应、解包”变成“给个指针”,代码里少了一整层序列化和缓冲管理。PD 分离、KV Cache 池化、专家并行,本质上都靠这个。
**第二层,距离变长了。**灵衢 2.0 走全光互联,能拉 200 米以上,还做了光路故障检测和保护切换。这点很多人忽略——1.68 TB/s 再快,如果只能在一个机柜里跑,超节点就永远是个“大机箱”。能拉 200 米,才谈得上跨柜组 1024 卡、8192 卡。
**第三层,它敢开放。**灵衢 2.0 的三份规范是公开的,还有兼容性测试规范、操作系统参考设计、管控运维参考设计。这在互联协议里不常见——IB 是被一家攥着的,UB 选择把规范摊开。
**第四层,运维有抓手。**云上提的“故障发现率 >98%、有效训练时长 >99%”,背后是 UB 的带内管理通道和 UBM 管理芯片。850E 的 CPU 抽屉里专门放了一颗 UBM 芯片和一个灵衢总线管理网口——超节点的网络是要单独管的,不能跟业务网混一起。做运维的看到这个细节,会知道分量。
7. 还差在哪
测完不吹,短板也得说。
**一是工具太薄。**urma_perftest 能测带宽和时延,但你没法看到一条路径上跑了几个包、在哪个节点被重路由、EID 到物理端口是怎么映射的。生产环境出问题,现在多是“现象级”排查,不是“包级”排查。对比 IB 那边几十年的工具积累,这块还在补。
**二是硬件只有一家。**规范开放了,社区也建了(有兼容测试工作组、定期会议、规范 2.0/2.1 在迭代),但目前能买到的 UB 硬件还是华为自己的。从规范开放走到生态繁荣,中间隔着好几年。
**三是软件适配要一个个验。**官方给了三条迁移路径:DeepEP 接口零修改、LD_PRELOAD 拦截 Socket、直接用 URMA 异步接口。路径越多,越说明没有一颗“自动全兼容”的银弹。哪条路能跑通、性能打几折,得按自己的框架慢慢试。
**四是认知成本。**团队里做运维的,习惯了看 IP、看端口、看路由表;换成 EID、Jetty、CTP/RTP,排查思路要重建一遍。这不是技术问题,是人的问题,而且比技术问题难解。
8. 写在最后
三台机器、26 个 EID、一条 urma_perftest,把一个抽象名词拽到了地上。
我最在意的其实不是那 6.8 GB/s,是 Transport mode : UB 这行字——它证明这条链路上没有任何一层偷偷退化。
超节点这词,过去两年被讲成了一堆数字的堆叠:多少卡、多少 PFLOPS、多少 PB/s。但真正决定它是不是“一台机器”的,是你写代码的时候,能不能把另一台机器的显存当成自己的。
灵衢做到了这一步。剩下的问题不在协议,在生态和时间。
评论区